پردازش موازی؛ تبدیل فایلهای حجیم تا ۱۲ برابر سریعتر شد
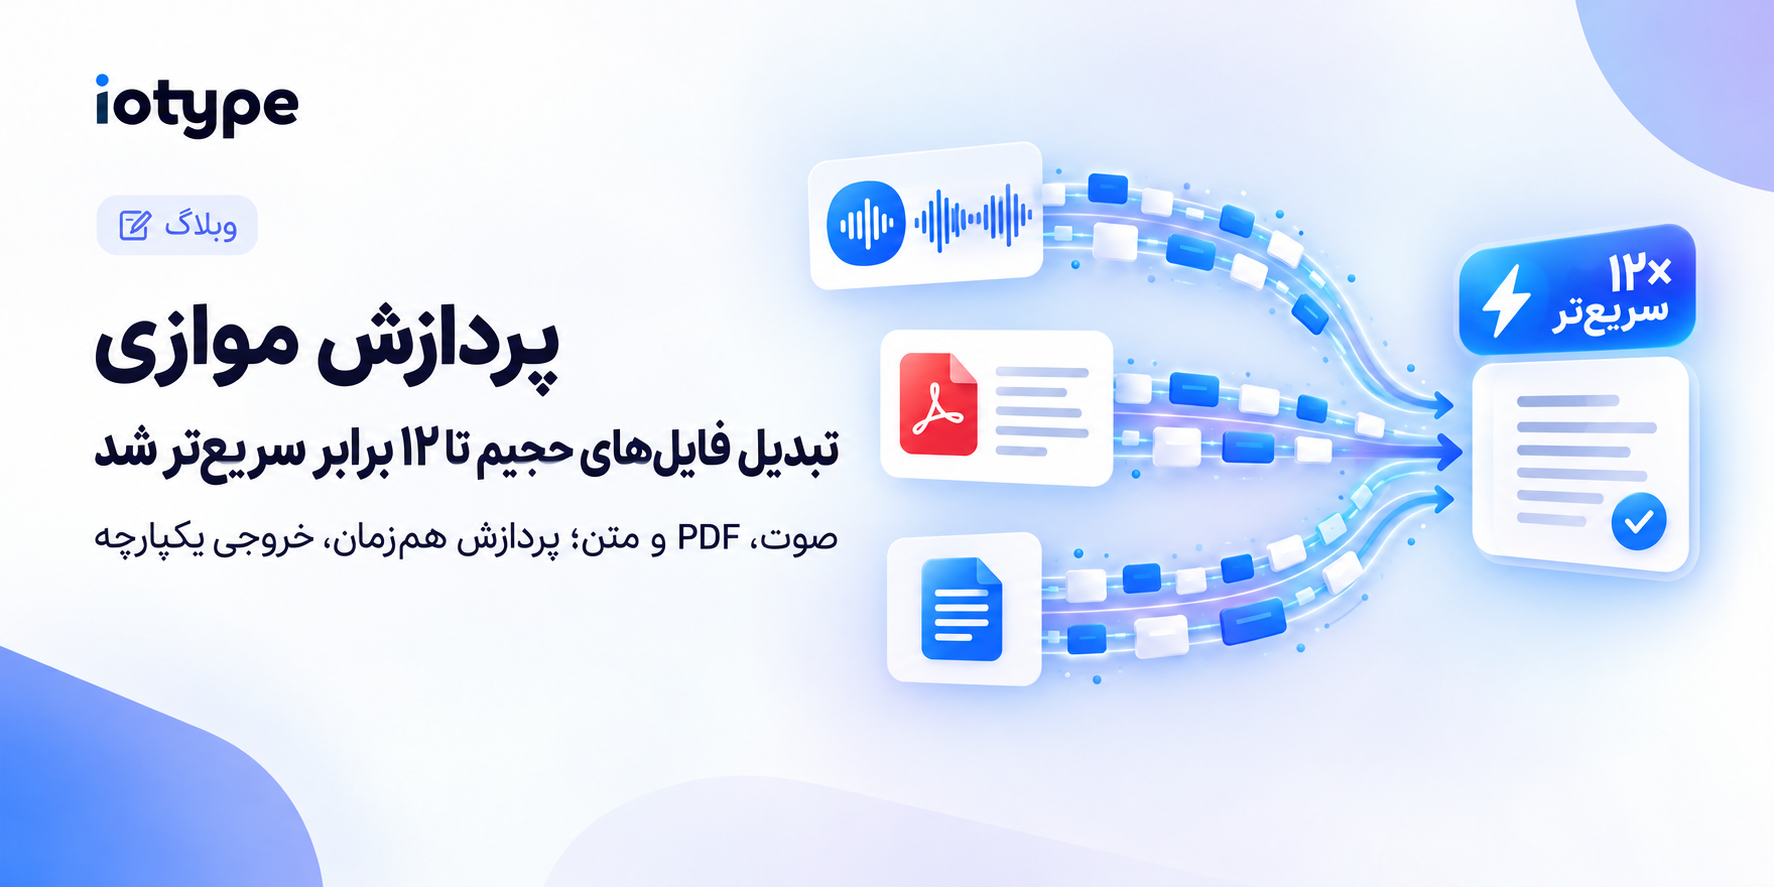
تا پیش از این، تبدیل یک فایل صوتی ۱۰۰ دقیقهای در آی او تایپ ۲۲ دقیقه طول میکشید. حالا همان فایل در ۱ دقیقه و ۵۰ ثانیه آماده میشود. در سرویس تبدیل متن به صوت هم سقف ۸۰۰ کلمه برداشته شد و حالا متن با هر طولی به یک فایل صوتی یکپارچه تبدیل میشود.
پشت هر سه این تغییرها یک ایده واحد نشسته است: فایل دیگر یکپارچه پردازش نمیشود. به چند بخش تقسیم میشود، همه بخشها همزمان پردازش میشوند و در پایان به ترتیب کنار هم قرار میگیرند. خروجی دقیقاً همان یک فایل همیشگی است، با همان قیمت.
این مقاله توضیح میدهد این تغییر چه بود، چرا بهبودش از سقف انتظار فراتر رفت، و تیم فنی در مسیر با چه مشکلاتی روبهرو شد.
در یک نگاه
- یک فایل صوتی ۱۰۰ دقیقهای که پیشتر در ۲۲ دقیقه پردازش میشد، اکنون در ۱ دقیقه و ۵۰ ثانیه آماده میشود — ۱۲ برابر سریعتر.
- یک فایل PDF صدصفحهای که پردازشش حدود ۱۰ دقیقه طول میکشید و اغلب با خطای وقفه زمانی متوقف میشد، اکنون در حدود ۴۵ ثانیه تکمیل میشود.
- در تبدیل متن به صوت، محدودیت ۸۰۰ کلمه حذف شد؛ متن با هر طولی به یک فایل صوتی یکپارچه تبدیل میشود. یک متن ۵۰۰ کلمهای هم که پیشتر در ۱۴ ثانیه آماده میشد، اکنون در ۶ ثانیه تحویل داده میشود.
- فایلهای صوتی به بخشهای ۱۰ دقیقهای تقسیم میشوند و برش در نزدیکترین پایان جمله انجام میشود.
- فایلهای PDF به بخشهای ۱۰ صفحهای تقسیم میشوند.
- متن ورودی سرویس صوت فقط در پایان پاراگراف یا پایان جمله بریده میشود، هرگز وسط کلمه، عدد اعشاری یا آدرس اینترنتی.
- فایلها و متنهای کوتاه، مثل گذشته یکجا پردازش میشوند.
- قیمت تغییری نکرده و همچنان بر اساس کل دقیقه، صفحه یا کلمه ورودی محاسبه میشود.
- این قابلیت روی وبسایت، اپلیکیشن موبایل و وبسرویس توسعهدهندگان فعال است و نیازی به بهروزرسانی اپلیکیشن یا تغییر کد ندارد.
روش اندازهگیری: اعداد در تاریخ ۲۱ مهر ۱۴۰۵ و روی فایلهای یکسان به دست آمدهاند؛ یک بار با قابلیت پردازش موازی خاموش و یک بار با آن روشن.
مشکل کجا بود؟
در روش قبلی، هر فایل یک درخواست واحد بود. فایل ۱۰۰ دقیقهای بهصورت یکپارچه وارد صف پردازش میشد و تا پایان کار همانجا میماند.
این طراحی برای فایلهای کوتاه کاملاً منطقی است. مشکل زمانی شروع میشود که فایل بزرگ باشد.
اول، زمان انتظار با طول فایل بالا میرفت. برای کاربری که فایل یک کلاس درس یا یک جلسه دوساعته را بارگذاری کرده بود، این یعنی ۲۲ دقیقه انتظار برای چیزی که قرار بود در کار روزمرهاش صرفهجویی کند.
دوم، و مهمتر، هر فایل حجیم منابع سختافزاری را برای مدت طولانی اشغال نگه میداشت. وقتی چند فایل بزرگ همزمان در صف بودند، ظرفیت پردازش به اشباع میرسید و زمان انتظار برای همه — از جمله کسی که فایل دو دقیقهای فرستاده بود — بالا میرفت.
در سمت PDF وضعیت جدیتر بود. پردازش یکجای یک سند صدصفحهای نهتنها حدود ۱۰ دقیقه طول میکشید، بلکه در موارد زیادی اصلاً به سرانجام نمیرسید و با خطای وقفه زمانی متوقف میشد.
و در تبدیل متن به صوت، مشکل اصلاً سرعت نبود؛ سقف بود. متنهای بلند از توان یک درخواست به موتور تولید صدا بیشتر بودند، به همین دلیل محدودیت ۸۰۰ کلمهای وجود داشت. کاربری که میخواست یک فصل کتاب یا یک مقاله کامل را به صوت تبدیل کند، باید متن را خودش تکهتکه میکرد، چند فایل جدا میگرفت و بعد آنها را با یک ابزار دیگر به هم میچسباند.
به همه اینها باید یک ریسک مشترک را هم اضافه کرد: اگر در دقیقه ۹۶ از یک پردازش صددقیقهای خطایی رخ میداد، کل کار باید از ابتدا انجام میشد.
راهحل: یک درخواست، چند پردازش همزمان
تصور کنید یک کتاب صدصفحهای را به یک گوینده بدهید. او از صفحه اول شروع میکند و تا صفحه صدم پیش میرود. حالا تصور کنید همان کتاب بین چند گوینده با صدای کاملاً یکسان تقسیم شود؛ همه همزمان میخوانند و در پایان بخشها با مکثهای طبیعی پشت سر هم گذاشته میشوند. فایل نهایی یکی است، اما زمان آماده شدنش بهکلی فرق دارد.
همین ایده در هر سه سرویس پیاده شد:
| سرویس | نحوه تقسیم | خروجی نهایی |
|---|---|---|
| تبدیل فایل صوتی به متن | بخشهای حدوداً ۱۰ دقیقهای | یک متن کامل، به ترتیب |
| تبدیل PDF و عکس به متن | بخشهای ۱۰ صفحهای | یک فایل Word کامل، به ترتیب صفحات |
| تبدیل متن و PDF به صوت | بخشهای کوتاه چندصدکلمهای، فقط در پایان جمله یا پاراگراف | یک فایل صوتی یکپارچه |
از همین جدول یک نکته مهم بیرون میآید: میزان بهبود به طول ورودی بستگی دارد. هرچه فایل طولانیتر باشد، به بخشهای بیشتری تقسیم میشود و سود بیشتری میبرد. یک فایل صوتی ۲۴ دقیقهای که فقط سه بخش میشود، طبیعتاً بهبودی در حد یک فایل ۱۰۰ دقیقهای تجربه نمیکند، و ورودیهای کوتاه هم اصلاً تقسیم نمیشوند چون تقسیمشان فقط سربار اضافه میسازد.
کل این فرایند خودکار است. کاربر فایل یا متن را مثل همیشه وارد میکند، هیچ گزینه جدیدی انتخاب نمیکند و یک خروجی یکپارچه تحویل میگیرد.
چالش اصلی: از کجا ببریم؟
اینجا سختترین تصمیم مهندسی این پروژه بود، و برای هر سرویس پاسخ متفاوتی داشت.
در فایل صوتی: نزدیکترین پایان جمله. اگر یک فایل صوتی را دقیقاً سر دقیقه ۱۰ ببرید، احتمال زیادی وجود دارد که وسط یک کلمه باشید؛ نتیجه، دو نیمه ناقص است که هوش مصنوعی هیچکدام را درست تشخیص نمیدهد. بهجای برش کور روی ثانیه ششصدم، سیستم در همان حوالی دنبال نزدیکترین نقطه پایان جمله میگردد. یعنی هر بخش تقریباً ۱۰ دقیقه است، نه دقیقاً ۱۰ دقیقه — و همین «تقریباً» چیزی است که محتوا را سالم نگه میدارد.
در PDF: مرز صفحه. یک مرز طبیعی که برش روی آن هیچ آسیبی به محتوا نمیزند.
در متن ورودی سرویس صوت: یک سلسلهمراتب مشخص. اولویت اول پایان پاراگراف است، بعد پایان جمله (نقطه، علامت سؤال، علامت تعجب)، و فقط اگر جملهای غیرعادی بلند باشد، ویرگول یا نقطهویرگول. علاوه بر این، اعداد اعشاری و آدرسهای اینترنتی هیچوقت وسط خودشان بریده نمیشوند. بخشها هم تقریباً هماندازه ساخته میشوند، نه چند بخش بلند و یک تکه کوتاه در انتها — این هم لحن خروجی را یکدستتر نگه میدارد و هم زمان کل را کم میکند.
تبدیل متن به صوت: از سقف ۸۰۰ کلمه تا متن بدون محدودیت
این سرویس بیشترین تغییر را تجربه کرد، چون علاوه بر تقسیم موازی، یک مرحله آمادهسازی هم به ابتدای مسیر اضافه شد.
مسیر متن پیش از تبدیل
وقتی متنی را وارد سرویس تبدیل متن به صوت میکنید، پیش از اینکه به موتور تولید صدا برسد، از چند مرحله عبور میکند:
۱. بررسی اولیه متن ۲. اصلاح علائم نگارشی و نیمفاصلهها — متنی که بدون نقطه و ویرگول تایپ شده، بدون مکث خوانده میشود و شنیدنش سخت است. این مرحله آهنگ طبیعی جملهها را برمیگرداند. ۳. اعرابگذاری — در فارسی بسیاری از کلمهها همنگاشتاند و تلفظشان فقط از روی متن مشخص نیست. «مِهر» و «مُهر» یا «کَرَم» و «کِرِم» دقیقاً یک شکل نوشته میشوند. اعرابگذاری پیش از تبدیل، به موتور صدا میگوید کدام تلفظ درست است. ۴. تقسیم به بخشهای متعادل بر اساس همان سلسلهمراتب برش ۵. تبدیل همزمان همه بخشها ۶. چسباندن نهایی و ساخت یک فایل صوتی یکپارچه
نتیجه این است که متن با هر طولی قابل تبدیل است و کاربر فایل صوتی را در همان درخواست دریافت میکند، نه بعداً.
تضمین اینکه متن شما دستنخورده میماند
مرحله اصلاح علائم نگارشی یک ریسک آشکار دارد: مدلهای زبانی گاهی وسوسه میشوند متن را «بهتر» کنند — یک کلمه را مترادفش بگذارند یا جملهای را روانتر بنویسند. برای متنی که کاربر خودش نوشته، این رفتار قابل قبول نیست.
به همین دلیل یک لایه بازبینی مستقل اضافه شد: خروجی مرحله آمادهسازی حرفبهحرف با متن اصلی مقایسه میشود. اگر حتی یک حرف، یک کلمه یا یک عدد اضافه، حذف یا عوض شده باشد، کل اصلاحات کنار گذاشته میشود و عیناً متن خود کاربر خوانده میشود. این بررسی را سیستم انجام میدهد، نه هوش مصنوعی — یعنی برای درستیاش به قضاوت همان مدلی که ممکن است اشتباه کند تکیه نمیشود.
این مرحله برای متنهای خیلی کوتاه انجام نمیشود و هیچ هزینه اضافهای برای کاربر ندارد.
چرا صدای نهایی بریدهبریده نیست
وقتی چند فایل صوتی جدا را به هم بچسبانید، نتیجه معمولاً شنیدنی نیست: مکثهای نامنظم، و گاهی صدای «تق» روی محل اتصال. سه کار این مشکل را حل کرد:
- صدای یکسان: همه بخشها با همان گوینده، لحن و سرعتی ساخته میشوند که کاربر انتخاب کرده.
- حذف سکوت اضافه: سکوتهای ابتدا و انتهای هر بخش بریده میشوند.
- مکث طبیعی: بهجای آنها مکثی مثل مکث یک گوینده واقعی قرار میگیرد — کوتاهتر بین جملهها، کمی بلندتر بین پاراگرافها. فایل نهایی هم یکپارچه و دوباره ساخته میشود، نه صرفاً چسبانده.
چرا بهبود به ۱۲ برابر رسید؟
روی کاغذ، تقسیم یک فایل به ۱۰ بخش همزمان باید حداکثر ۱۰ برابر سریعتر باشد. اما عدد اندازهگیریشده ۱۲ برابر شد و در PDF به حدود ۱۳ برابر رسید. این مازاد از کجا آمد؟
دلیلش به همان مشکل دوم برمیگردد. در روش قبلی، رشد زمان پردازش با طول فایل خطی نبود، بدتر از خطی بود. یک فایل بسیار طولانی منابع را برای مدت زیادی قفل میکرد و عملاً باعث کندی خودش میشد؛ هرچه فایل بزرگتر، فشار روی ظرفیت پردازش بیشتر و بازده هر دقیقه پردازش کمتر.
وقتی همان فایل به ده قطعه کوچک تبدیل شد، هر قطعه در زمان کوتاهی تمام میشود و منابع را آزاد میکند. یعنی علاوه بر سود مستقیم همزمانی، یک سود غیرمستقیم هم به دست آمد: حذف نقطه اشباع.
به بیان ساده، ده بخش دهدقیقهای مجموعاً سریعتر از یک فایل صددقیقهای پردازش میشوند — حتی اگر یکییکی و پشت سر هم پردازش میشدند. وقتی این سود با همزمانی ترکیب شد، نتیجه نهایی از سقف نظری ۱۰ برابر عبور کرد.
پشت صحنه: پنج مشکلی که در مسیر پیدا شد
۱. بخشها به ترتیب تمام نمیشوند
وقتی ده بخش همزمان پردازش میشوند، ممکن است بخش هفتم زودتر از بخش سوم آماده شود. اگر به ترتیب آماده شدن به هم چسبانده میشدند، خروجی بههمریخته بود.
راهحل: هر بخش یک شماره ترتیب دارد و چسباندن فقط زمانی انجام میشود که همه بخشها تمام شده باشند — آن هم دقیقاً به ترتیب شماره، نه به ترتیب آماده شدن.
۲. چسباندن دوباره، روی یک فایل ۲۴ دقیقهای
در آزمایشها یک مورد جالب پیدا شد: اگر دو بخش آخر دقیقاً در یک لحظه تمام شوند، هر دو همزمان نتیجه میگیرند که «همه بخشها آمادهاند» و فرایند چسباندن دو بار اجرا میشود.
این تداخل روی یک فایل ۲۴ دقیقهای رخ داد و شناسایی شد. راهحل این بود که هنگام چسباندن، کار برای بقیه قفل شود تا این مرحله فقط یک بار اجرا شود؛ و اگر بخشی به قفل برخورد کند، خودکار دوباره تلاش میکند.
۳. تکههای PDF که باز نمیشدند
در مرحله اول پیادهسازی، ابزار برش PDF گاهی تکههایی تولید میکرد که اصلاً قابل باز شدن نبودند. ابزار برش عوض شد و یک مرحله اعتبارسنجی اضافه شد: پیش از ارسال هر تکه، تعداد صفحات آن بررسی میشود.
مهمتر از آن، یک مسیر بازگشت خودکار تعریف شد. اگر برش به هر دلیلی شکست بخورد، سیستم بیسروصدا به روش قبلی برمیگردد و فایل را یکجا پردازش میکند.
۴. اندازه مناسب بخشهای متن
در سرویس صوت، بخشهای خیلی بلند از سوی موتور تولید صدا پذیرفته نمیشدند و بخشهای خیلی کوتاه هم سربار اضافه میساختند. اندازه نهایی در آزمایش واقعی تنظیم شد تا هر بخش مطمئناً در توان یک درخواست باشد.
۵. اعتماد به هوش مصنوعی در ویرایش متن
همان مسئلهای که بالاتر توضیح داده شد: راهحل، مقایسه حرفبهحرف خروجی با ورودی و رد کردن هر تغییری جز علائم نگارشی و فاصلههاست.
برای کاربر چه چیزی عوض میشود؟
| موضوع | پیش از تغییر | پس از تغییر |
|---|---|---|
| فایل صوتی ۱۰۰ دقیقهای | ۲۲ دقیقه | ۱ دقیقه و ۵۰ ثانیه |
| PDF صدصفحهای | حدود ۱۰ دقیقه، اغلب با خطای وقفه زمانی | حدود ۴۵ ثانیه |
| تبدیل متن ۵۰۰ کلمهای به صوت | ۱۴ ثانیه | ۶ ثانیه |
| حداکثر طول متن قابل تبدیل به صوت | ۸۰۰ کلمه | بدون محدودیت |
| رفتار هنگام خطا | کل کار از ابتدا | فقط همان بخش دوباره تلاش میکند |
| نوار پیشرفت | تخمینی | بر اساس تعداد بخشهای تمامشده |
| قیمت | بر اساس کل دقیقه، صفحه یا کلمه | بدون تغییر |
ردیف چهارم از همه مهمتر است. برداشته شدن سقف ۸۰۰ کلمه یک بهبود سرعت نیست، یک تغییر کیفی است: کاری که قبلاً باید دستی و در چند مرحله انجام میشد، حالا یک درخواست ساده است.
پایداری بیشتر هم بهاندازه سرعت اهمیت دارد: اگر یکی از ده بخش با مشکل موقت مواجه شود، فقط همان یک بخش دوباره تلاش میشود و ۹۰ دقیقه کار انجامشده هدر نمیرود. اگر بخشی به هیچ وجه درست نشد، خروجی ناقص تحویل داده نمیشود و چیزی هم از اعتبار کاربر کم نمیشود.
چه چیزی عوض نمیشود؟
شفاف بودن درباره مرزهای یک تغییر، بهاندازه خود تغییر مهم است:
- قیمتگذاری دستنخورده است. هزینه همچنان بر اساس کل دقیقه فایل صوتی، کل صفحه فایل PDF یا تعداد کلمه متن محاسبه میشود. تقسیم فایل و مرحله آمادهسازی متن هیچ هزینه اضافهای ندارند.
- خلاصهنویسی خودکار روی متن کامل انجام میشود، نه روی تکهها. پس از چسباندن بخشها، خلاصه از روی متن یکپارچه تولید میشود و انسجام متن حفظ میماند.
- برای PDFهای بزرگ، چیدمان اصلی صفحه حفظ نمیشود. خروجی، متن کامل و مرتب همه صفحات است اما جدولها بهصورت متن ردیفبهردیف میآیند. این محدودیت ربطی به پردازش موازی ندارد و از قبل هم وجود داشت.
- متن شما تغییر نمیکند. مرحله آمادهسازی فقط علائم نگارشی و نیمفاصله را اصلاح میکند و هر تغییر دیگری بهصورت خودکار رد میشود.
- ورودیهای کوتاه بهبود مستقیمی نمیبینند، چون اصلاً تقسیم نمیشوند.
کجا فعال است؟
این تغییر همزمان در سه سرویس و سه بستر فعال شده است.
سرویسها: تبدیل فایل صوتی به متن · تبدیل عکس و PDF به متن · تبدیل متن و PDF به صوت
بسترها: وبسایت، اپلیکیشن موبایل (بدون نیاز به بهروزرسانی)، و وبسرویس توسعهدهندگان (بدون نیاز به هیچ تغییری در کد شما؛ همان درخواست قبلی، فقط سریعتر پاسخ میگیرد).
دلیل اینکه هیچکدام به تغییر نیاز ندارند این است که تقسیم و چسباندن در لایه پردازش سمت سرور انجام میشود؛ ورودی و خروجی دقیقاً همان چیزی است که قبلاً بود.
پرسشهای متداول
پردازش یک فایل صوتی ۱۰۰ دقیقهای چقدر طول میکشد؟ در تست ۲۱ مهر ۱۴۰۵، یک فایل ۱۰۰ دقیقهای در ۱ دقیقه و ۵۰ ثانیه پردازش شد؛ پیش از فعال شدن پردازش موازی، همان فایل ۲۲ دقیقه زمان میبرد. زمان واقعی به ظرفیت همزمان سرور در لحظه بارگذاری بستگی دارد.
حداکثر طول متنی که میتوانم به صوت تبدیل کنم چقدر است؟ محدودیتی وجود ندارد. سقف ۸۰۰ کلمهای قبلی برداشته شده و متن با هر طولی به یک فایل صوتی یکپارچه تبدیل میشود.
آیا فایل صوتی خروجی بین بخشها بریدهبریده میشود؟ خیر. برش متن فقط در پایان جمله یا پاراگراف انجام میشود، همه بخشها با همان گوینده و لحن انتخابی ساخته میشوند، سکوت اضافه حذف میشود و بین بخشها مکثی طبیعی قرار میگیرد.
آیا هوش مصنوعی متن من را تغییر میدهد؟ خیر. مرحله آمادهسازی فقط علائم نگارشی و نیمفاصلهها را اصلاح میکند. خروجی حرفبهحرف با متن اصلی مقایسه میشود و اگر حتی یک کلمه تغییر کرده باشد، کل اصلاحات کنار گذاشته میشود و متن خودتان خوانده میشود.
آیا باید کار جدیدی انجام دهم تا این قابلیت فعال شود؟ خیر. فایل یا متن را مثل همیشه وارد کنید. تقسیم بهصورت خودکار و فقط برای ورودیهای بلند انجام میشود.
آیا هزینه بیشتر میشود؟ خیر. محاسبه هزینه دقیقاً مثل گذشته بر اساس کل دقیقه، صفحه یا کلمه ورودی است و تعداد بخشها هیچ تأثیری در قیمت ندارد. تعرفهها را در صفحه تعرفه سرویسها ببینید.
اگر یکی از بخشها با خطا مواجه شود چه میشود؟ همان بخش جداگانه دوباره تلاش میکند و نیازی به پردازش مجدد کل فایل نیست. اگر بخشی به هیچ وجه پردازش نشود، خروجی ناقص تحویل داده نمیشود.
فایل کوتاه من هم سریعتر شده؟ ورودیهای کوتاه مثل قبل یکجا پردازش میشوند، اما چون فایلهای حجیم دیگر منابع را برای مدت طولانی اشغال نمیکنند، صف پردازش در ساعات شلوغ روانتر حرکت میکند.
این قابلیت روی ترجمه فایل هم اعمال میشود؟ در حال حاضر روی تبدیل فایل صوتی به متن، تبدیل PDF و عکس به متن، و تبدیل متن و PDF به صوت فعال است.
جمعبندی
بزرگترین بهبودهای سرعت معمولاً از سختافزار قویتر نمیآیند، بلکه از تغییر شکل مسئله به دست میآیند. اینجا پرسش «چطور یک فایل صددقیقهای را سریعتر پردازش کنیم» به پرسش «چرا اصلاً باید آن را یک فایل صددقیقهای در نظر بگیریم» تبدیل شد — و همین تغییر زاویه، انتظار ۲۲ دقیقهای را به کمتر از دو دقیقه رساند، سقف ۸۰۰ کلمهای را برداشت و در کنار همه اینها پایداری سرویس را هم بالا برد.
اگر فایل صوتی طولانی دارید، همین حالا میتوانید تفاوت را ببینید؛ ۵ دقیقه اول رایگان است. برای تبدیل متنهای بلند به فایل صوتی هم سرویس متن به صوت دیگر محدودیتی ندارد. و اگر هنوز با تایپ صوتی زنده کار نکردهاید، برای متنهایی که از ابتدا مینویسید گزینه سریعتری است.
برای آشنایی بیشتر با فرایند کار، مقاله پیاده سازی فایل صوتی جلسات و سخنرانی راهنمای کاملی است. در صورت داشتن هر سؤالی هم پشتیبانی آنلاین پاسخگوی شماست.